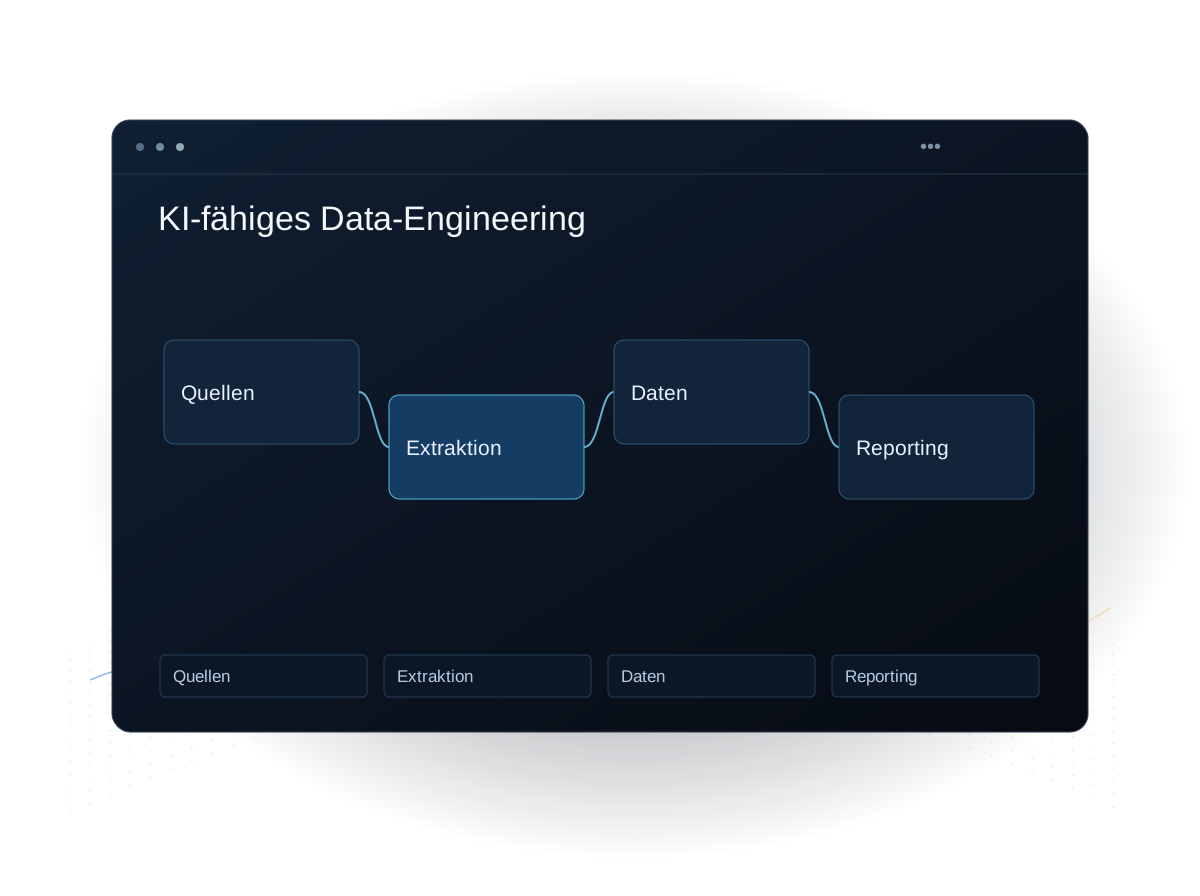
Datenpipelines, Warehouses und Governance für Analytics, BI und KI.
Mindrops baut die Pipelines, Warehouses und Governance, die verstreute Daten in einer zentral verwalteten Quelle für Analytics, BI und KI zusammenführen.
Software, die Mindrops in diesem Bereich für Kunden konzipiert und entwickelt hat.
SaaS · Influencer-Marketing
Activate by Bloglovin'
Ein dediziertes Onshore- und Offshore-Team von Mindrops hat die Plattform agil aufgebaut, weiterentwickelt und gewartet – mit Kampagnen-Matching, Messaging und Echtzeit-Reporting.
Mehr als 4 Jahre lang betreut und auf über 130.000 Influencer und über 100.000 Marken skaliert – in einem Netzwerk mit über 16 Mio. Nutzern pro Monat.
Cafés in Indien50+Filialen in ganz Indien, unterstützt von den Systemen, die wir gebaut habenSeit 1963
KI · Gastronomie
BeanBot – The Coffee Bean & Tea Leaf
Ein einbettbarer KI-Chat-Assistent auf Basis von Live-Katalog- und Filialdaten, mit „Order Now“-Aktion bei jedem Produkt und einer No-Code-Admin-Konsole für Inhalte und Preise.
Live in über 50 Filialen in Indien, mit rund 10.000 Gesprächen im Monat und etwa 50 Bestellungen pro Tag.
Extraktionsgenauigkeit99 %mit Human-in-the-Loop-Prüfung, bei Zehntausenden Dokumenten im MonatBritische Kanzlei
KI · Buchhaltung
Caelum AI – Dokumentenverarbeitung
Ein Document-Intelligence-Produkt von Mindrops, das Transaktionen, Rechnungspositionen, Summen und Datumsangaben über eine REST-API als Excel, CSV, JSON oder XML ausgibt – mit Prüfung durch Menschen (Human in the Loop).
Erreicht 99 % Extraktionsgenauigkeit bei unterstützten Dokumenten – Kontoauszügen, Rechnungen und Belegen.
Mindrops baut die Pipelines, Speichersysteme und Governance, die die Daten einer Organisation verlässlich und nutzbar machen – Batch- und Streaming-Pipelines, Warehouses und Lakehouses, Datenqualität und Governance sowie KI-fähige Daten (Features und Vektoren) als Basis für verlässliche Analytics und Machine Learning.
01
Pipelines & ETL/ELT
Verlässliche Batch- und Streaming-Pipelines, die Daten auch in großen Mengen bewegen und transformieren.
02
Warehouse & Lakehouse
Moderne Datenplattformen, die jedem Team eine verlässliche Single Source of Truth geben.
03
Datenqualität
Validierung, Tests und Observability, sodass Entscheidungen auf sauberen Daten beruhen.
04
Echtzeit & Streaming
Event-Streams und CDC für sekundenaktuelle Daten, wo es darauf ankommt.
05
Daten für ML & LLMs
Feature- und Vektor-Pipelines, die Ihre Daten für ML und LLMs nutzbar machen.
06
Governance
Lineage, Zugriffskontrolle und Katalogisierung für Vertrauen und Compliance.
Für wen wir Datenplattformen entwickeln
Unternehmen am Start eines KI-Programms
Modelle sind nur so gut wie die Daten dahinter. Wir bewerten die Datenreife und bauen die Pipelines und Vector Stores, die der erste Use Case braucht.
Teams mit Datensilos
Vertrieb, Finanzen und Operations führen jeweils eigene Zahlen. Ein Warehouse oder Lakehouse vereint sie in einer zentral verwalteten Quelle.
Analysten, die mit fehlerhaften Reports kämpfen
Pipelines fallen unbemerkt aus, und Dashboards wiederholen die Fehler von gestern. Tests, Validierung und Observability fangen Probleme frühzeitig an der Quelle ab.
Produkte, die Live-Daten brauchen
Bestand, Preise oder Status müssen sich in Sekunden aktualisieren. Streaming- und Change-Data-Capture-Pipelines halten nachgelagerte Systeme aktuell.
Warum Mindrops für Data-Engineering
Datenschichten hinter Live-KI
Wir haben die Vektor- und Fuzzy-Search-Schicht in PostgreSQL hinter BeanBot und die Extraktions-Pipelines hinter Caelum AI gebaut – das Data-Engineering, auf dem funktionierende KI beruht.
Quellsysteme bleiben unberührt
Unsere Plattform zur Buchhaltungsprüfung liest ein Live-Hauptbuch und schreibt Befunde in einen separaten Speicher, ohne die Quelle je zu verändern – ein Prinzip, das wir bei jeder Integration mit Kernsystemen anwenden.
Erfahrung in echtem Maßstab
Activate by Bloglovin’, eine Influencer-Marketing-SaaS, die wir mehr als vier Jahre lang gebaut und betreut haben, bedient über 16 Mio. Nutzer und mehr als 130.000 Influencer – Daten in diesem Umfang müssen verlässlich modelliert und bewegt werden.
Die einfachste Plattform für den Use Case
Wir empfehlen das schlankeste Warehouse-, Lakehouse- oder Datenbank-Setup, das den Use Case erfüllt – damit Sie nicht für Infrastruktur zahlen, die Sie nicht brauchen.
Eingesetzte Technologien
Storage & compute
PostgreSQL · MySQL · MSSQL · PySpark
Pipelines
ETL / ELT · CDC · Streaming · Airflow-style
AI data
Vector DBs · Embeddings · Feature stores
Cloud
AWS · Azure · GCP · Docker
Kundenbewertungen
KI-gestützte Fahrzeugüberwachung
Computer Vision am Tor einer Mine erfasst Kennzeichen, Fahrzeugbewegungen und Fahrtenzahlen für die tägliche Berichterstattung.
Aus der Kundenbewertung
“Die Tagesberichte liegen von selbst bereit, sodass sich niemand am Schichtende hinsetzen und sie erstellen muss.”
Ein Mindrops-Team, das gemeinsam mit den eigenen Entwicklern des Kunden an Softwareentwicklung und Cloud-Projekten arbeitet – als verlässliche zusätzliche Kapazität.
Aus der Kundenbewertung
“Mindrops hat komplexe Anforderungen mühelos umgesetzt und während des gesamten Projekts echten Mehrwert geliefert.”
Lieferantenrechnungen werden automatisch gelesen und ausgewertet, gespeichert und an die Buchhaltungstools übergeben, die das Finanzteam bereits nutzt.
Aus der Kundenbewertung
“Die KI-Extraktion, die sie gebaut haben, funktioniert zuverlässig mit unterschiedlichen Rechnungsformaten – genau das, was wir in erster Linie brauchten.”
Der Aufbau von Pipelines, Speichersystemen, Datenqualität und Governance, die Daten verlässlich machen – und die gezielte Strukturierung der Daten (Features, Vektoren), damit Analytics, ML und LLMs sie nutzen können.
Brauchen wir ein Warehouse oder ein Lakehouse?
Das hängt von Ihren Daten und Use Cases ab. Wir bewerten Ihre Situation und empfehlen die einfachste Plattform, die Ihre Analytics- und KI-Anforderungen erfüllt, ohne Over-Engineering.
Können Sie Echtzeitdaten verarbeiten?
Ja. Wir bauen Streaming- und Change-Data-Capture-Pipelines für sekundenaktuelle Daten, wo der Use Case es erfordert.
Wie sichern Sie die Datenqualität?
Validierung, automatisierte Tests und Observability über die Pipelines hinweg, sodass Probleme erkannt werden, bevor sie Dashboards oder Modelle erreichen.
Welche Rolle spielt das für KI?
Verlässliche, gut strukturierte Daten sind die Voraussetzung für nützliche KI – wir bauen die Feature- und Vektor-Pipelines, auf die unsere KI-Projekte angewiesen sind.
Kontakt
Erzählen Sie uns, wo Ihre Daten liegen und wofür sie genutzt werden sollen. Wir empfehlen die einfachste passende Plattform und antworten innerhalb eines Werktags.