Pipelines, entrepôts et gouvernance des données pour l’analytique, la BI et l’IA.
Mindrops construit les pipelines, les entrepôts et la gouvernance qui réunissent des données éparpillées dans une source unique et gouvernée, pour l’analytique, la BI et l’IA.
Des logiciels que Mindrops a conçus et développés pour des clients dans ce domaine.
SaaS · Marketing d’influence
Activate by Bloglovin'
Une équipe Mindrops dédiée, onshore et offshore, a développé, fait évoluer et maintenu la plateforme en mode agile : matching de campagnes, messagerie et reporting en temps réel.
Maintenue pendant plus de 4 ans, la plateforme est passée à plus de 130 000 influenceurs et plus de 100 000 marques, sur un réseau de plus de 16 millions d’utilisateurs par mois.
Cafés en Inde50+cafés dans toute l’Inde, servis par les systèmes que nous avons conçusDepuis 1963
IA · Restauration
BeanBot – The Coffee Bean & Tea Leaf
Un assistant conversationnel IA intégrable, fondé sur les données en direct du catalogue et des cafés, avec une action « Order Now » sur chaque produit et une console d’administration no-code pour les contenus et les prix.
En service dans plus de 50 points de vente en Inde : environ 10 000 conversations par mois et une cinquantaine de commandes par jour.
Précision d’extraction99 %avec validation humaine, sur des dizaines de milliers de documents par moisCabinet comptable britannique
IA · Comptabilité
Caelum AI – Traitement de documents
Un produit Mindrops d’intelligence documentaire qui extrait transactions, lignes, totaux et dates vers Excel, CSV, JSON ou XML via une API REST, avec relecture humaine (human-in-the-loop).
Atteint 99 % de précision d’extraction sur les documents pris en charge : relevés bancaires, factures et reçus.
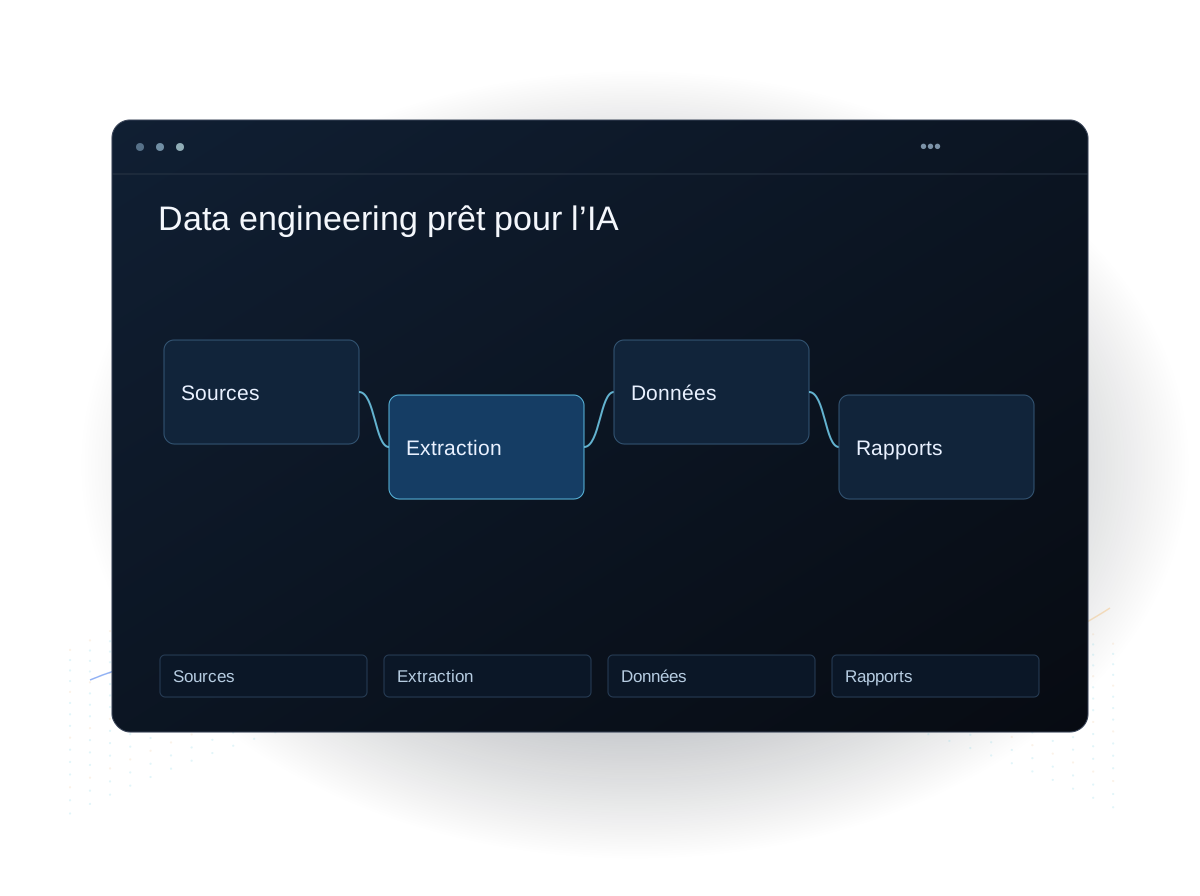
Le data engineering, c’est la conception et la construction des pipelines, du stockage et de la gouvernance qui rendent les données d’une organisation fiables et exploitables. Mindrops construit des pipelines batch et streaming, des entrepôts et des lakehouses, de la qualité et de la gouvernance des données, ainsi que les données prêtes pour l’IA (features et vecteurs) qui alimentent une analytique et un machine learning fiables.
01
Pipelines & ETL/ELT
Des pipelines batch et streaming fiables qui déplacent et transforment les données à grande échelle.
02
Entrepôt & lakehouse
Des plateformes de données modernes qui donnent à chaque équipe une source de vérité unique et fiable.
03
Qualité des données
Validation, tests et observabilité pour que les décisions reposent sur des données propres.
04
Temps réel & streaming
Flux d’événements et CDC pour des données à la seconde là où cela compte.
05
Données pour le ML et les LLM
Des pipelines de features et de vecteurs qui rendent vos données exploitables par le ML et les LLM.
06
Gouvernance
Lignage, contrôle d’accès et catalogage des données, pour la confiance et la conformité.
Pour qui nous construisons des plateformes de données
Entreprises qui lancent un programme IA
Un modèle ne vaut que par ses données. Nous évaluons la maturité des données et construisons les pipelines et bases vectorielles dont le premier cas d’usage a besoin.
Équipes aux données cloisonnées
Ventes, finance et opérations tiennent chacune leurs propres chiffres. Un entrepôt ou un lakehouse les réunit dans une source gouvernée.
Analystes confrontés à des rapports défaillants
Les pipelines échouent en silence et les tableaux de bord reprennent les erreurs de la veille. Tests, validation et observabilité interceptent les problèmes en amont.
Produits qui exigent des données en temps réel
Stocks, prix ou statuts doivent se mettre à jour en quelques secondes. Les pipelines de streaming et de capture des changements (CDC) maintiennent les systèmes en aval à jour.
Pourquoi Mindrops pour le data engineering
Les couches de données d’une IA en production
Nous avons construit la couche vectorielle et de recherche floue sur PostgreSQL qui fait tourner BeanBot, ainsi que les pipelines d’extraction de Caelum AI : le data engineering dont dépend toute IA qui fonctionne.
Les systèmes de référence restent intacts
Notre plateforme de contrôle comptable lit un grand livre en direct et écrit ses constats dans un stockage distinct, sans jamais modifier la source : un principe que nous appliquons à toute intégration avec des systèmes centraux.
Une expérience à grande échelle
Activate by Bloglovin’, un SaaS de marketing d’influence que nous avons construit et maintenu pendant plus de 4 ans, sert plus de 16 millions d’utilisateurs et 130 000 influenceurs ; à ce volume, les données doivent être modélisées et transférées de façon fiable.
La plateforme la plus simple pour le cas d’usage
Nous recommandons l’entrepôt, le lakehouse ou la base de données le plus léger qui réponde au cas d’usage, pour que vous ne payiez pas une infrastructure inutile.
Technologies utilisées
Storage & compute
PostgreSQL · MySQL · MSSQL · PySpark
Pipelines
ETL / ELT · CDC · Streaming · Airflow-style
AI data
Vector DBs · Embeddings · Feature stores
Cloud
AWS · Azure · GCP · Docker
Avis clients
Suivi des véhicules par IA
La vision par ordinateur à l’entrée d’une mine enregistre les plaques, les mouvements de véhicules et les trajets pour les rapports quotidiens.
Extrait de l’avis du client
“Les rapports quotidiens sont prêts d’eux-mêmes, sans que personne ait à s’asseoir pour les préparer en fin de poste.”
Une équipe Mindrops qui travaille aux côtés des ingénieurs du client sur des projets de développement logiciel et cloud, pour apporter une capacité de livraison fiable.
Extrait de l’avis du client
“Mindrops a géré des exigences complexes avec aisance et a apporté de la valeur tout au long du projet.”
Une application terrain et une interface d’administration web réunissent les mouvements de marchandises, les dépenses et les rapports de plusieurs entrepôts.
Extrait de l’avis du client
“Les rapports qui demandaient auparavant une journée entière de compilation de tableaux se résument désormais à un téléchargement filtré depuis l’interface d’administration.”
Une application client, une application partenaire et un back-office réalisés par une seule équipe, avec KYC, contrôles de crédit CIBIL et approbation automatisée des prêts.
Extrait de l’avis du client
“Les projets fintech comportent de nombreuses couches, et c’était appréciable de travailler avec une équipe qui comprenait le volet crédit et prêt.”
Qu’est-ce que le data engineering prêt pour l’IA ?
Construire les pipelines, le stockage, la qualité et la gouvernance qui rendent les données fiables – et les structurer spécifiquement (features, vecteurs) pour que l’analytique, le ML et les LLM puissent les utiliser.
Avons-nous besoin d’un entrepôt ou d’un lakehouse ?
Cela dépend de vos données et de vos cas d’usage. Nous évaluons et recommandons la plateforme la plus simple qui réponde à vos besoins d’analytique et d’IA, sans sur-ingénierie.
Pouvez-vous gérer les données en temps réel ?
Oui. Nous construisons des pipelines de streaming et de capture des changements (CDC) pour des données à la seconde là où le cas d’usage l’exige.
Comment assurez-vous la qualité des données ?
Validation, tests automatisés et observabilité à travers les pipelines, pour que les problèmes soient détectés avant d’atteindre les tableaux de bord ou les modèles.
En quoi cela soutient-il l’IA ?
Des données fiables et bien structurées sont le prérequis d’une IA utile – nous construisons les pipelines de features et de vecteurs dont dépendent nos projets d’IA.
Nous contacter
Dites-nous où se trouvent vos données et ce qu’elles doivent alimenter. Nous recommandons la plateforme la plus simple qui convienne et répondons sous un jour ouvré.