Pipelines, évaluation et monitoring pour les systèmes LLM et ML en production.
Mindrops construit les pipelines, l’évaluation, le déploiement et le monitoring qui mènent les prototypes LLM et ML en production, avec versions tracées, seuils de qualité et suivi des coûts.
Une sélection des logiciels que Mindrops a conçus et développés pour ses clients.
IA · ML
Développement de produits d’IA
Mindrops a développé en Python quatre produits de machine learning en production : maintenance prédictive, mensuration par vision par ordinateur, attribution multicanal et prévision des effectifs par deep learning.
Coûts de maintenance réduits de 25 %, retours en baisse de 20 %, ventes en hausse de 15 % et précision des prévisions améliorée de 90 %, chez les clients concernés.
Cafés en Inde50+cafés dans toute l’Inde, servis par les systèmes que nous avons conçusDepuis 1963
IA · Restauration
BeanBot – The Coffee Bean & Tea Leaf
Un assistant conversationnel IA intégrable, fondé sur les données en direct du catalogue et des cafés, avec une action « Order Now » sur chaque produit et une console d’administration no-code pour les contenus et les prix.
En service dans plus de 50 points de vente en Inde : environ 10 000 conversations par mois et une cinquantaine de commandes par jour.
Bureaux de poste au total165 000Le plus grand réseau postal du monde
Secteur public · GovTech
India Post – Gestion des réclamations
Une plateforme automatisée par l’IA, bâtie sur le socle LazyMonkey de Mindrops, qui catégorise, priorise et oriente chaque réclamation et y répond automatiquement, avec un dossier unique suivi par SLA pour les équipes centrales et régionales.
Attribuée via GeM (nov. 2025), elle trie automatiquement des milliers de réclamations par jour pour un réseau de plus de 150 000 bureaux de poste.
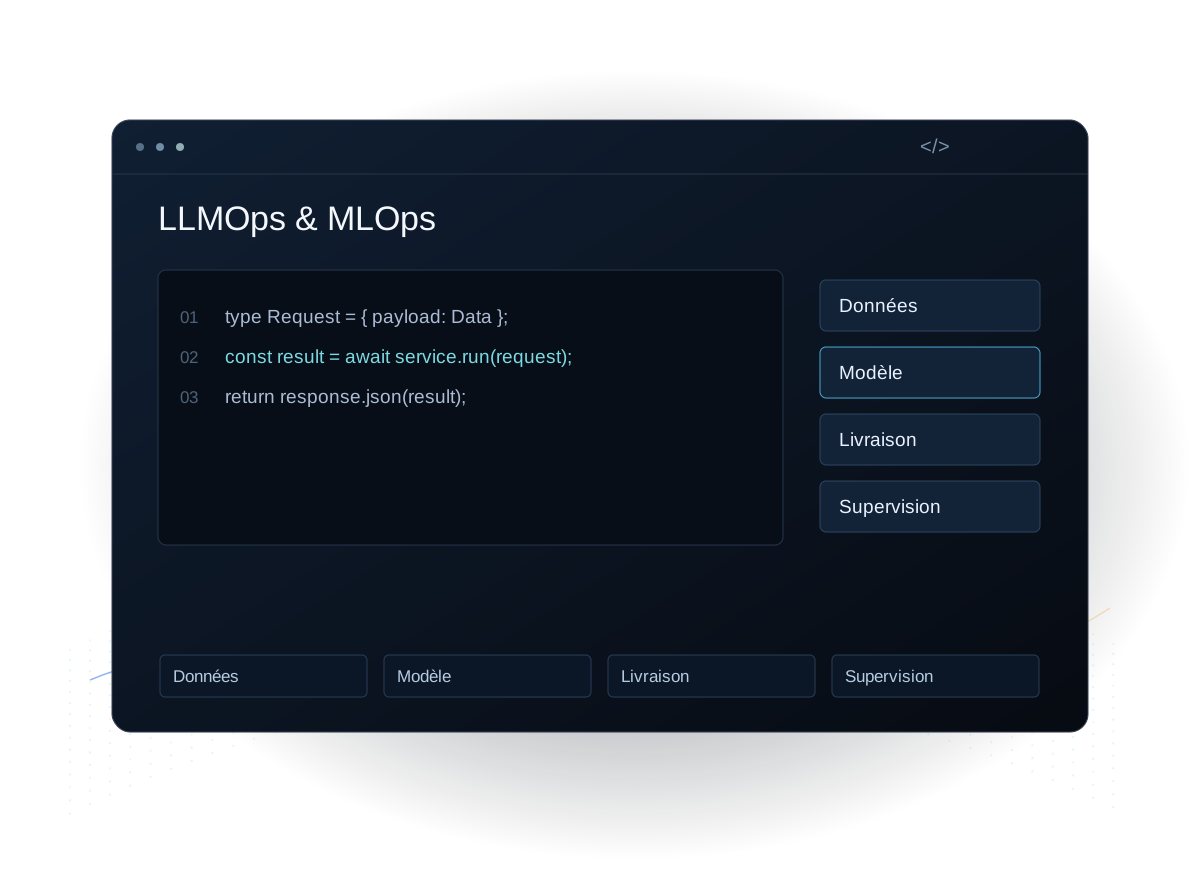
Le LLMOps et le MLOps sont les pratiques et l’outillage qui permettent de mettre en production de façon fiable des systèmes de machine learning et de grands modèles de langage – pipelines de données et d’entraînement, évaluation, déploiement, monitoring et maîtrise des coûts. Mindrops construit et exploite ce cycle de vie pour que votre IA reste précise, observable et économique en production.
01
Pipelines & automatisation
Pipelines reproductibles de données, d’entraînement et d’inférence avec versioning et CI/CD pour modèles et prompts.
02
Évaluation & tests
Évaluations automatisées, tests de régression et seuils de qualité (quality gates), pour que chaque changement soit livré avec ses résultats de tests.
03
Déploiement & serving
Serving de modèles évolutif et à faible latence – API managées, auto-hébergées ou hybrides selon les besoins de résidence des données.
04
Monitoring & dérive
Monitoring en production de la qualité, de la latence, de la dérive et des hallucinations, avec alertes et traçage.
05
Coût & performance
Stratégies de tokens, de mise en cache et de routage qui gardent l’IA rapide et économique, même à grande échelle.
06
Sécurité & gouvernance
Contrôle d’accès, gestion des secrets, audit et garde-fous intégrés au pipeline dès le premier jour.
Qui a besoin de LLMOps ou de MLOps
Équipes avec un prototype dans un notebook
Un modèle ou une application LLM fonctionne dans un notebook, sans pipeline, tests ni monitoring. Nous mettons en place tout ce qu’exige une mise en production fiable.
Produits IA aux coûts d’inférence croissants
Les dépenses en tokens augmentent plus vite que l’usage. Routage, cache et choix de modèle ramènent les coûts sous contrôle sans perte de qualité.
Équipes data science qui déploient à la main
Les modèles sont réentraînés et publiés manuellement, et personne ne sait quelle version est en ligne. Des pipelines versionnés et la CI/CD règlent le problème.
Équipes dont les modèles dérivent
Prévisions et classifieurs perdent discrètement en précision quand les données changent. Le suivi de la dérive et des réentraînements planifiés permettent de le repérer tôt.
Pourquoi Mindrops pour le LLMOps et le MLOps
Du ML classique en production
Nous avons construit et livré des modèles de prévision, de détection d’anomalies, de vision par ordinateur et d’attribution – dont une prévision d’effectifs LSTM à 30 jours pour un distributeur d’électricité.
Les coûts pensés dès le premier jour
BeanBot traite les clics sur les boutons et les requêtes de menu sans aucun appel au modèle, et n’envoie à un LLM que les questions ouvertes : une discipline de routage que nous appliquons à chaque système LLM.
Observabilité à chaque requête
Traces étape par étape, consommation de tokens et analyse des résultats à chaque interaction : les régressions de qualité et de coût apparaissent aussitôt dans un tableau de bord.
Ops et cloud sous un même toit
Nos équipes SRE et cloud managé exploitent l’infrastructure de serving, si bien que les pipelines de modèles héritent des mêmes alertes, sauvegardes et contrôles d’accès que le reste de votre stack.
Technologies utilisées
LLM & ML
OpenAI / LLMs · Anthropic · RAG · PyTorch
Pipelines & serving
Docker · CI/CD · Vector DBs · Serverless
Observability
Tracing · Evals · Drift detection · Dashboards
Cloud
AWS · Azure · GCP
Avis clients
Renfort pour le logiciel et le cloud
Une équipe Mindrops qui travaille aux côtés des ingénieurs du client sur des projets de développement logiciel et cloud, pour apporter une capacité de livraison fiable.
Extrait de l’avis du client
“Mindrops a géré des exigences complexes avec aisance et a apporté de la valeur tout au long du projet.”
Une application terrain et une interface d’administration web réunissent les mouvements de marchandises, les dépenses et les rapports de plusieurs entrepôts.
Extrait de l’avis du client
“Les rapports qui demandaient auparavant une journée entière de compilation de tableaux se résument désormais à un téléchargement filtré depuis l’interface d’administration.”
Une application client, une application partenaire et un back-office réalisés par une seule équipe, avec KYC, contrôles de crédit CIBIL et approbation automatisée des prêts.
Extrait de l’avis du client
“Les projets fintech comportent de nombreuses couches, et c’était appréciable de travailler avec une équipe qui comprenait le volet crédit et prêt.”
Nous examinons comment données, modèles et prompts passent aujourd’hui de l’expérimentation à la production, et où ce chemin se rompt.
02 – Pipeline
Versionnage & CI/CD
Les pipelines de données, d’entraînement et d’inférence sont versionnés et automatisés, avec des évaluations servant de seuils de qualité à chaque changement.
03 – Serving
Managé, auto-hébergé ou hybride
Les modèles sont déployés via des API managées, en auto-hébergement ou en hybride selon les exigences de latence, de coût et de résidence des données.
04 – Observer
Surveiller & réentraîner
Qualité, dérive, latence et dépenses sont surveillées avec alertes, et réentraînements ou mises à jour de prompts passent par les mêmes contrôles.
Le MLOps couvre le cycle de vie des modèles de machine learning ; le LLMOps applique la même discipline aux systèmes fondés sur de grands modèles de langage – prompts, recherche documentaire, évaluations et coût des tokens. Nous faisons les deux, de bout en bout.
Notre prototype fonctionne mais n’est pas fiable en production. Pouvez-vous aider ?
Oui, c’est précisément l’objet de ce service. Nous ajoutons pipelines, évaluation, monitoring et garde-fous pour que le système se comporte de façon prévisible et que les régressions soient détectées avant que les utilisateurs ne les voient.
Pouvez-vous maîtriser nos coûts d’exploitation de l’IA ?
Oui. Nous mettons en place mise en cache, routage, sélection de modèles et stratégies de tokens, et suivons les dépenses, pour que la qualité reste élevée et le coût maîtrisé.
Pouvez-vous auto-héberger les modèles pour la résidence des données ?
Oui. Nous déployons un serving managé, auto-hébergé ou hybride selon vos exigences de latence, de coût et de résidence des données.
Quel est le lien avec la gouvernance ?
Le LLMOps met en œuvre une grande partie de ce qu’exige la gouvernance de l’IA – évaluations, monitoring et audit – sous forme d’infrastructure opérationnelle.
Nous contacter
Dites-nous ce qui est déjà en production, ou ce qui bloque en amont. Nous identifions les manques de vos pipelines, évaluations et monitoring, et répondons sous un jour ouvré.